市面上的文生图模型,选起来很容易只看参数和样图。但真正决定能不能用的,是三件事:出图速度、尺寸能不能听话、模型会不会自己乱加东西。
这篇是实测记录。同样的提示词、同样的尺寸,分别喂给 MiniMax-H3-Image 和 SenseNova u1.5-lite,6 组风格 × 2 个模型 = 12 张图,逐张看下来,差别比想象中更具体。
怎么测的
6 组提示词,风格各自不同:写实摄影、赛博朋克霓虹、水墨国风、扁平矢量插画、3D 渲染、极简线稿。尺寸也跟着换,覆盖 16:9、3:1、4:3、1:1、2:1、9:16 六种比例:
| 组 | 风格 | 出图尺寸 | 比例 |
| 01 | 写实摄影 | 2048×1152 | 16:9 |
| 02 | 赛博朋克霓虹 | 3072×1024 | 3:1 |
| 03 | 水墨国风 | 1536×1152 | 4:3 |
| 04 | 扁平矢量插画 | 1024×1024 | 1:1 |
| 05 | 3D 渲染 | 2048×1024 | 2:1 |
| 06 | 极简线稿 | 1024×1792 | 9:16 |
每一组内部,两个模型收到的是逐字节相同的提示词和同一个尺寸参数,所以每组的两张图是严格 A/B。提示词全是中文,且刻意不包含任何标题文案、署名或数字统计类的要求。
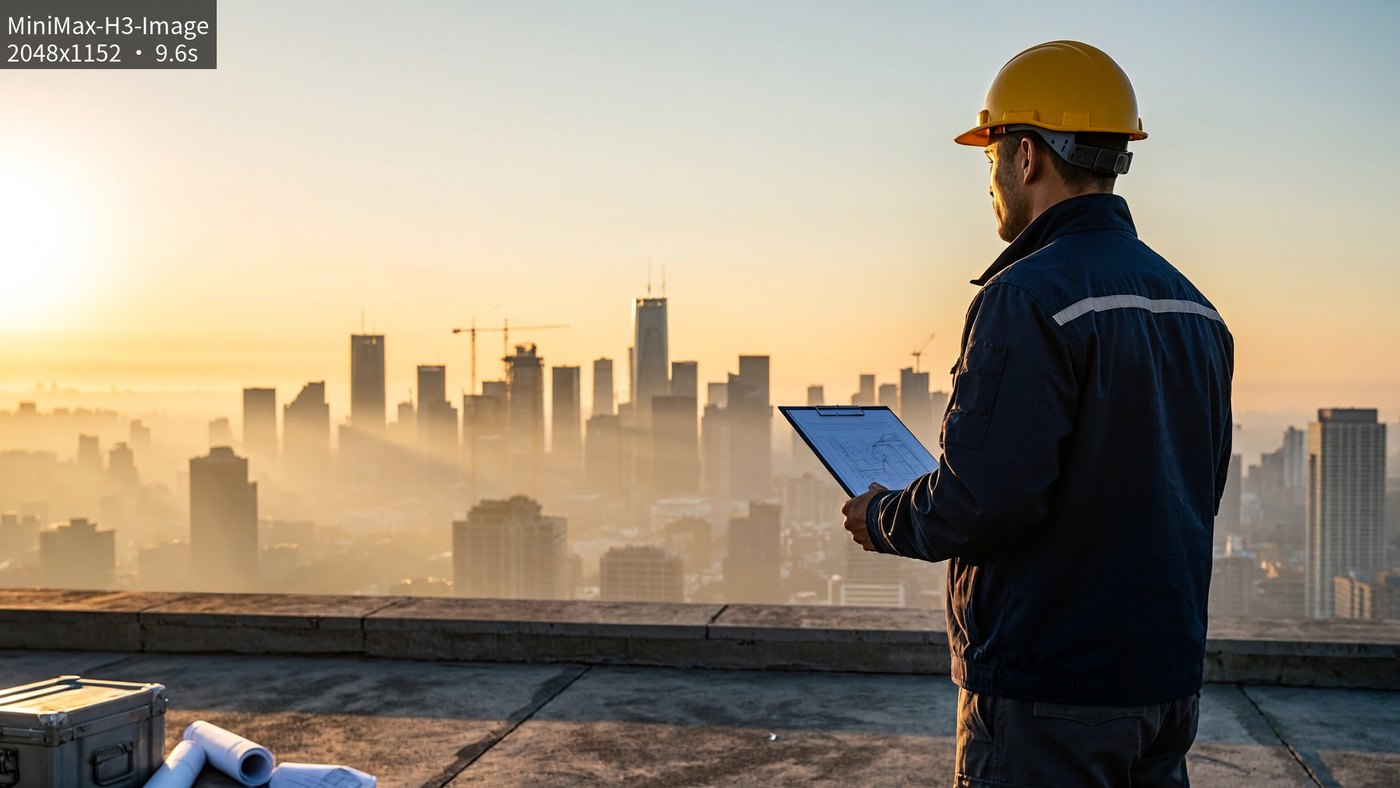
图 1:01 组 MiniMax-H3-Image,2048×1152,9.6 秒。
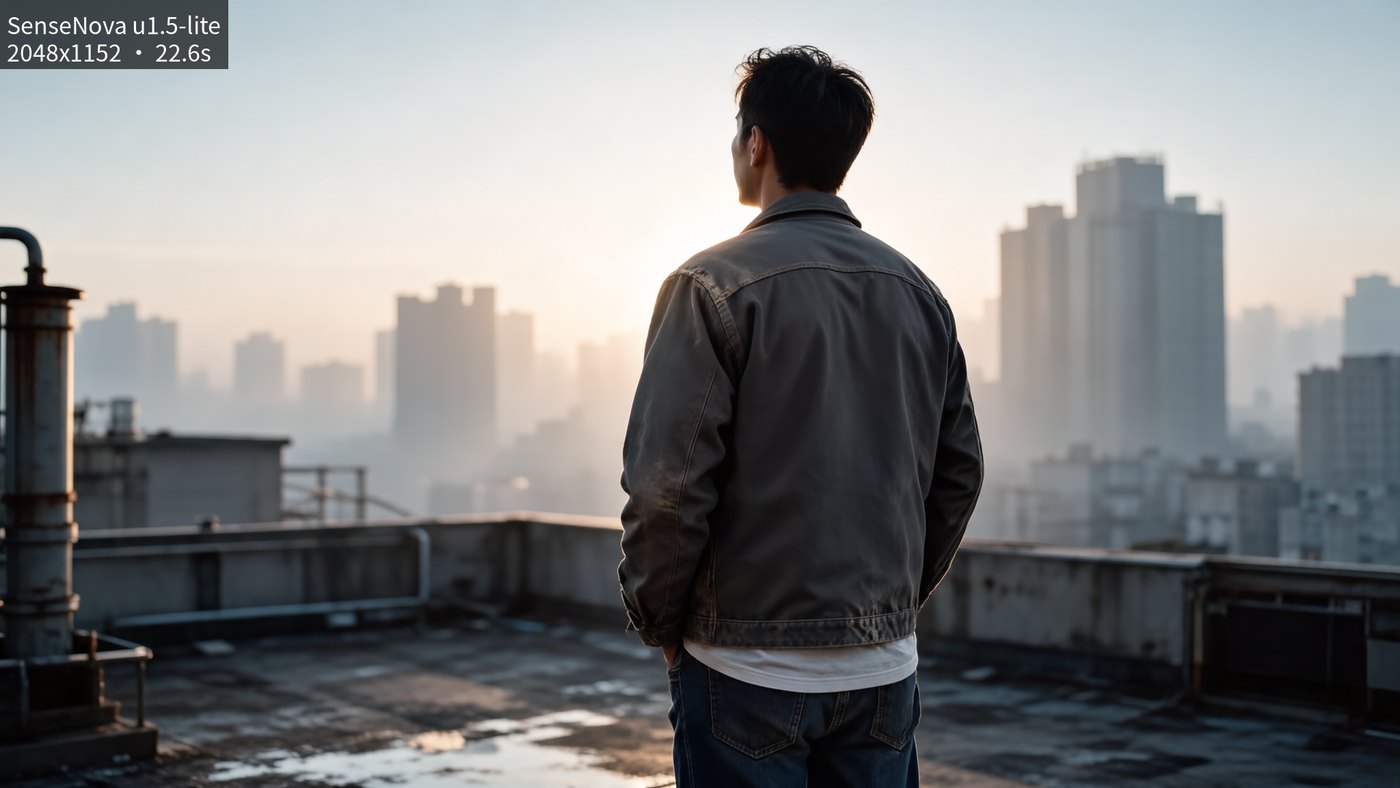
图 2:01 组 SenseNova u1.5-lite,2048×1152,22.6 秒。同一段提示词。
第一个结论:SenseNova 有尺寸硬门槛
12 张图,12 次全部精确命中请求的尺寸,没有一个模型擅自改比例。这一点上两家打平。
但测试中踩到一个真实的坑:第 3 组原本定的 1600×1200,SenseNova 直接返回 HTTP 400,而 MiniMax-H3-Image 同一尺寸正常出图。
原因是 SenseNova 对尺寸有三条硬规则——宽高必须各自是 32 的倍数、各自在 512 到 4096 之间、宽高比不能超过 3:1。1600 是 32 的倍数,1200 不是。最后把这一组的尺寸统一改成 1536×1152,两个模型才都能通过。
这条规则本身是好事,它挡住了不合规的请求。但如果你要做批量自动化,所有尺寸提前对齐到 32 的倍数,能省掉一整类随机失败。
第二个结论:H3 稳定快一倍
| 组 | 风格 | H3 耗时 | SenseNova 耗时 | 速度比 |
| 01 | 写实摄影 | 9.6 s | 22.6 s | 2.35× |
| 02 | 赛博朋克霓虹 | 11.5 s | 21.9 s | 1.90× |
| 03 | 水墨国风 | 10.0 s | 19.7 s | 1.97× |
| 04 | 扁平矢量插画 | 8.9 s | 19.0 s | 2.13× |
| 05 | 3D 渲染 | 8.7 s | 19.2 s | 2.21× |
| 06 | 极简线稿 | 10.4 s | 19.7 s | 1.89× |
H3 均值 9.9 秒,SenseNova 均值 20.4 秒,六组全部 H3 更快,而且 H3 的波动更小(8.7 到 11.5 秒),SenseNova 几乎恒定在 19 到 23 秒。
对"一文一图、当天出稿"这种场景,等待时间直接砍半。SenseNova 目前免费,作为兜底链路完全够用。
第三个结论:H3 会自己加料
这是差异最容易被忽略、但对出图影响最大的地方。
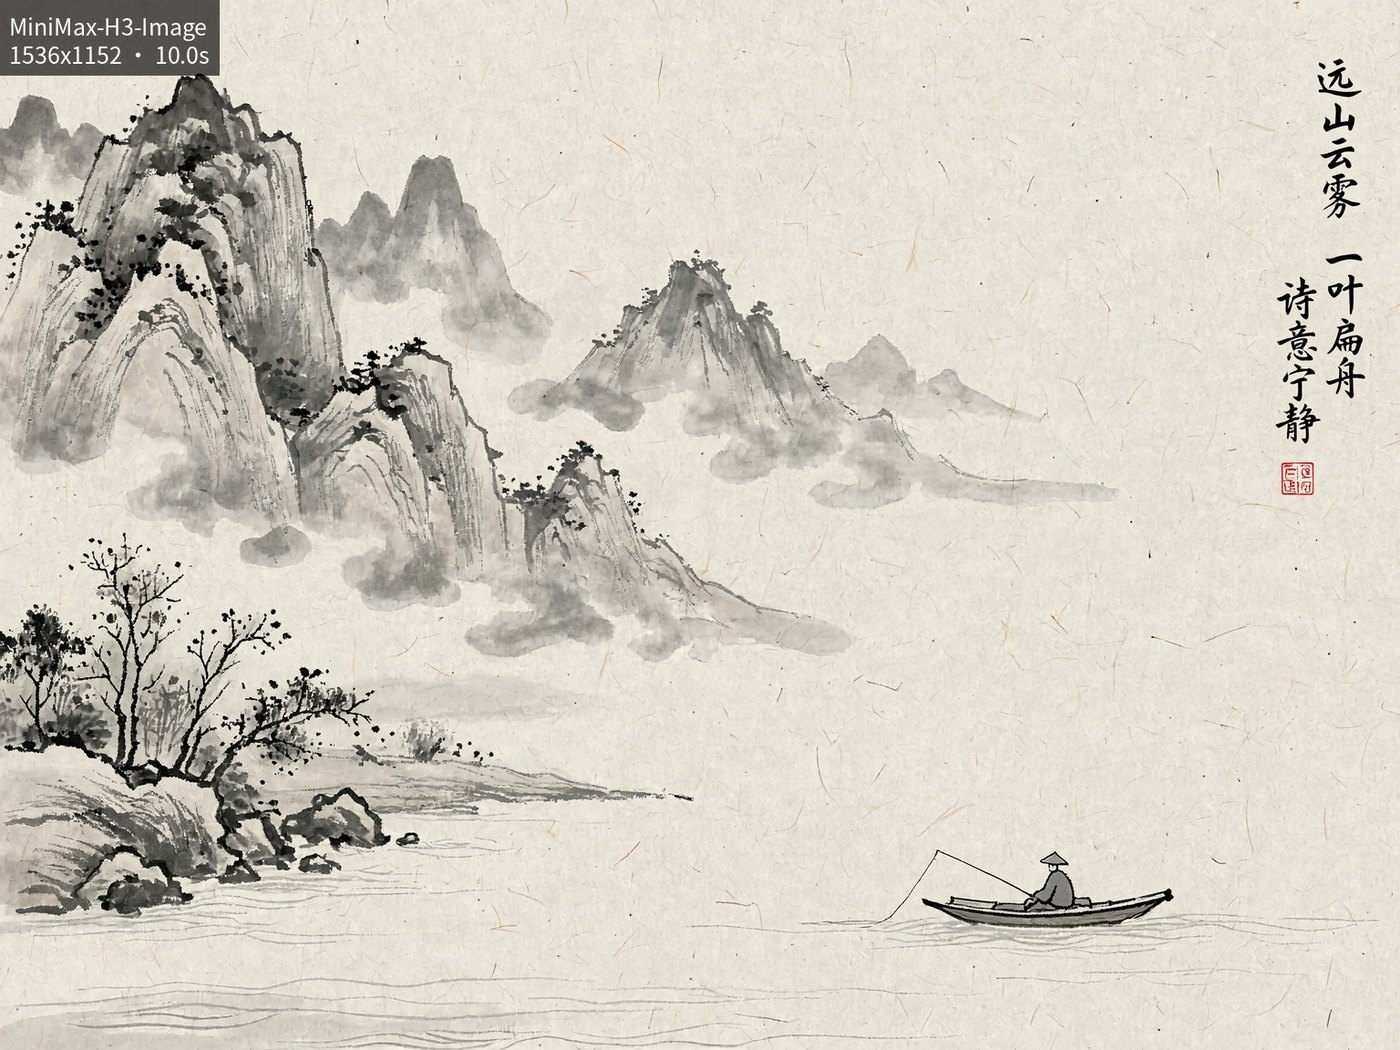
图 3:03 组 MiniMax-H3-Image。提示词没要求任何文字,它自己加了竖排题字"远山云雾/一叶扁舟/诗意宁静"和一枚朱红印章——题字是能读通的中文简体,印章的篆文则糊到不可辨,是枚"假篆"。
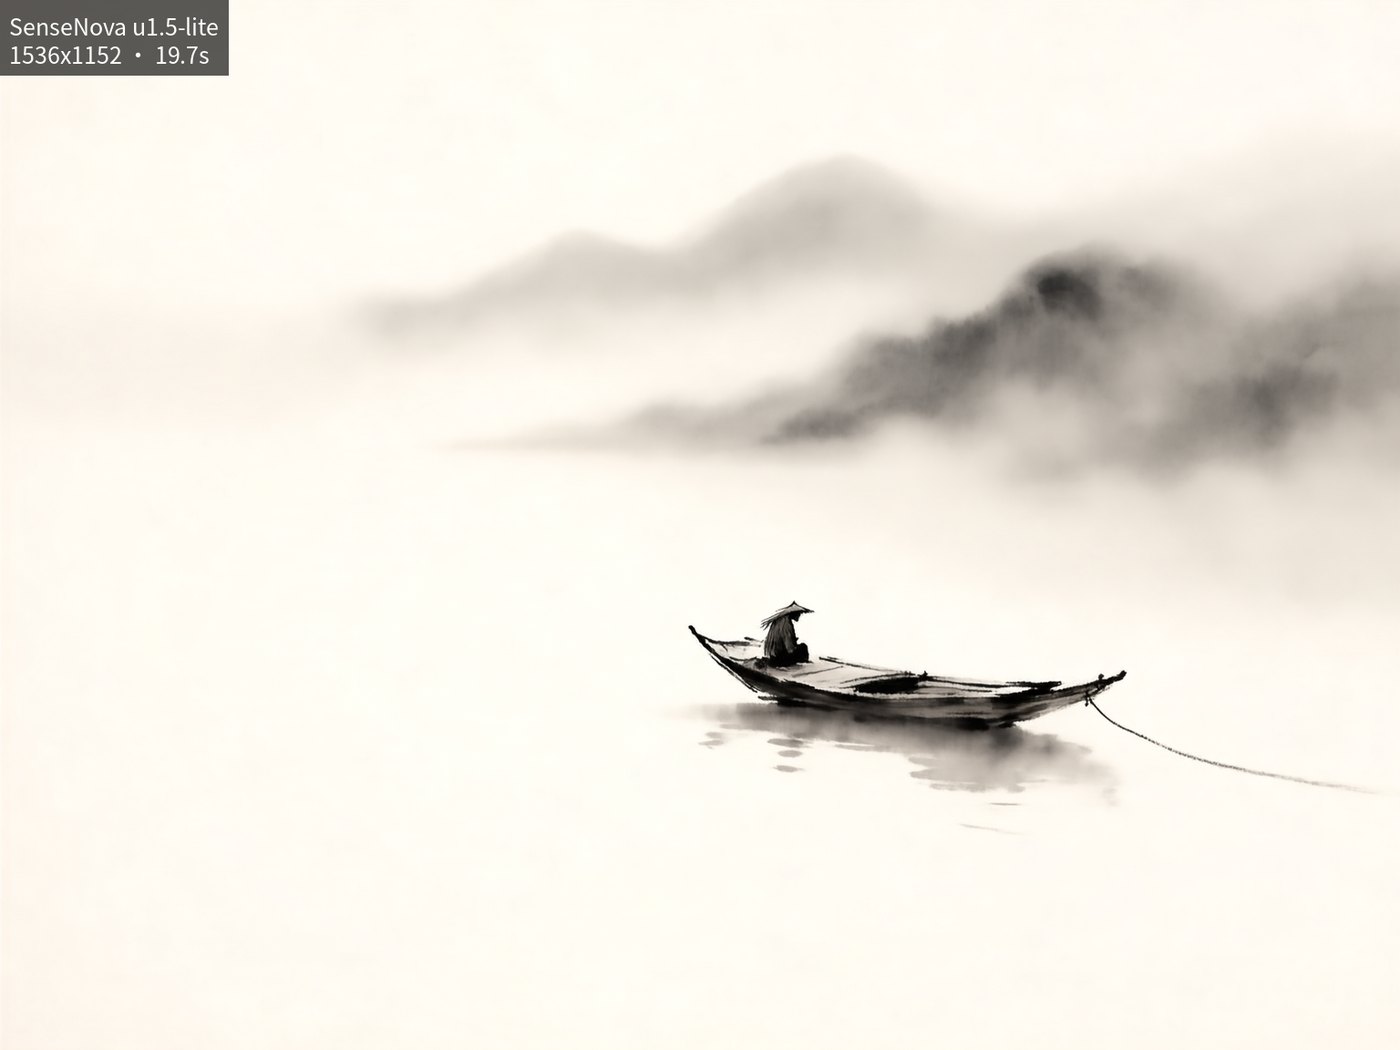
图 4:03 组 SenseNova u1.5-lite。同一段提示词,一个字都不加,纯画面。
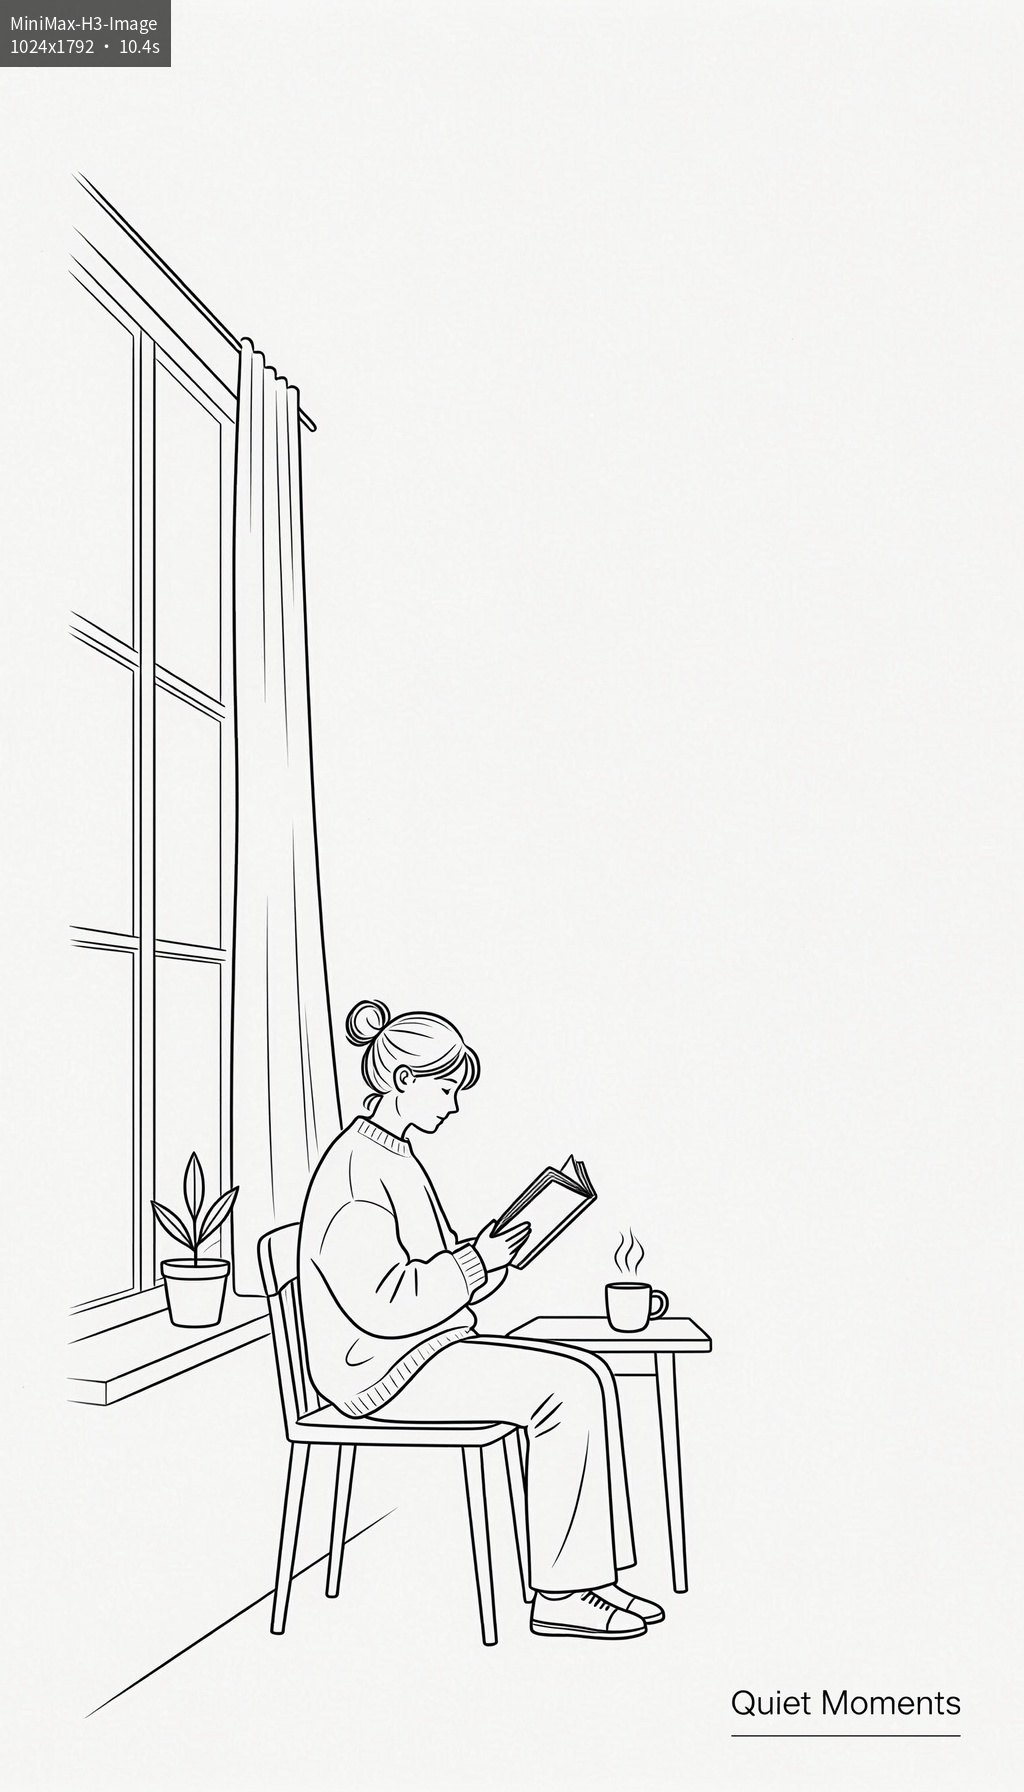
图 5:06 组 MiniMax-H3-Image。同样擅自加了右下角的英文标题 "Quiet Moments"。
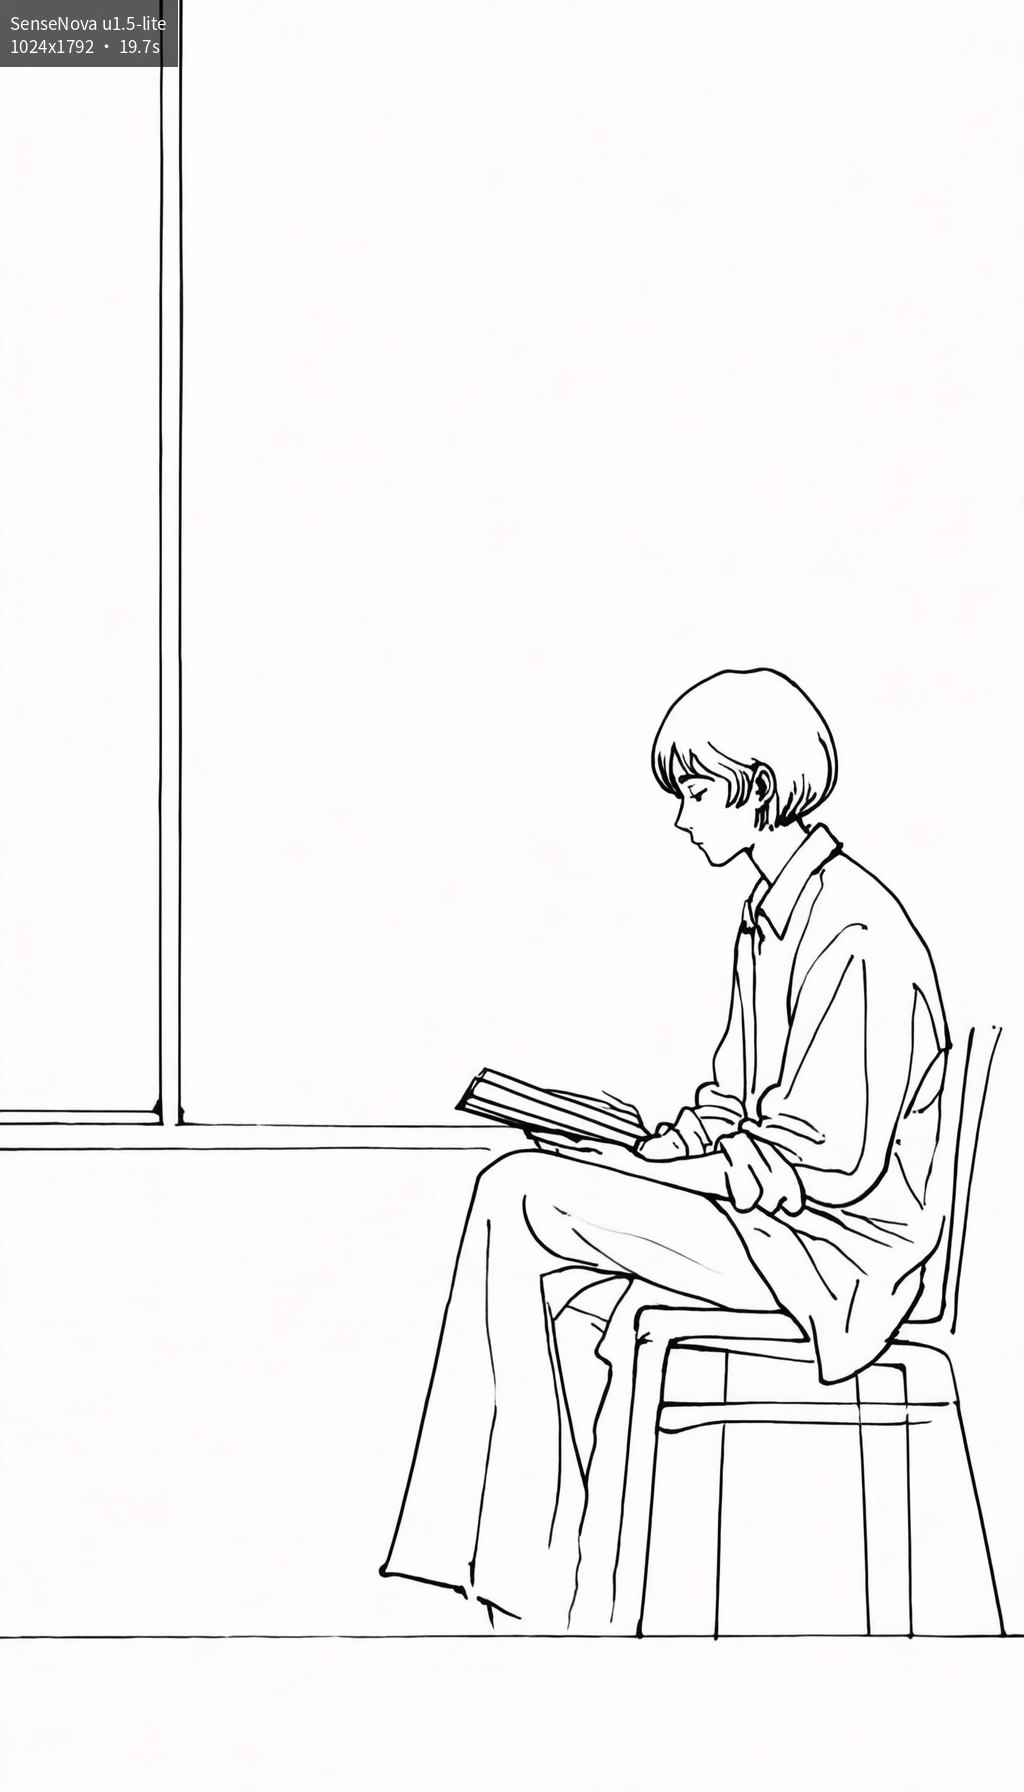
图 6:06 组 SenseNova u1.5-lite。窗边读书,只有两根竖线暗示窗户,人物缩在右下角。
规律很清楚:H3 主动往画面里加东西——水墨组加题字印章,线稿组加英文标题,写实组加了安全帽和蓝图板,3D 组加了烧瓶和数据屏。SenseNova 基本只画提示词里点名的东西。
这不一定是坏事。写实那组里,H3 加的安全帽、反光工装和施工图纸让"工程师"这个身份立住了,SenseNova 的画面就只是"一个人站在天台上"。但当你写的是"留白""极简"这类词,H3 的加料就是直接破坏——06 组它加的标题正好压在需要留白的位置。
要精确控图,SenseNova 更听话;要画面丰富、有氛围细节,H3 更划算。
第四个结论:细节完成度,插画类差距最大
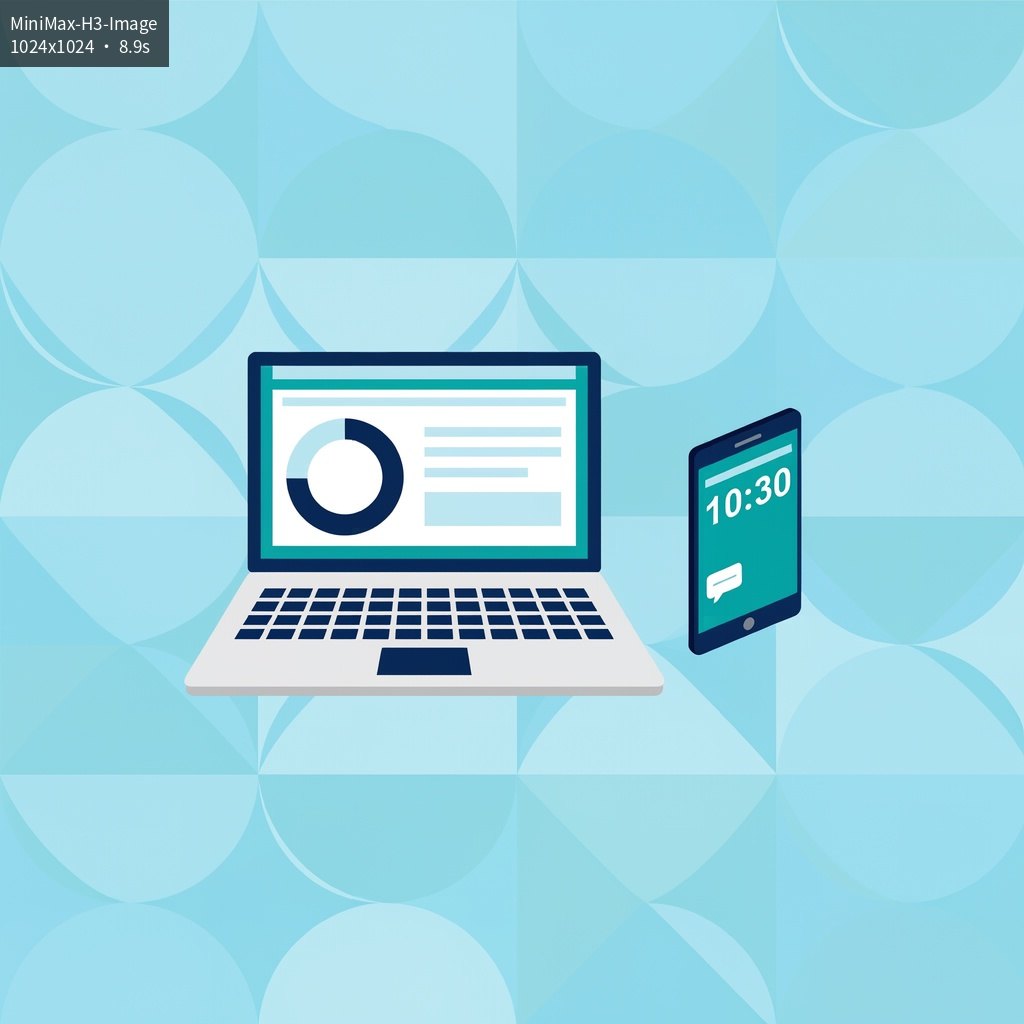
图 7:04 组 MiniMax-H3-Image。完整的键盘、触控板、环形统计图,手机上"10:30"也画对了。
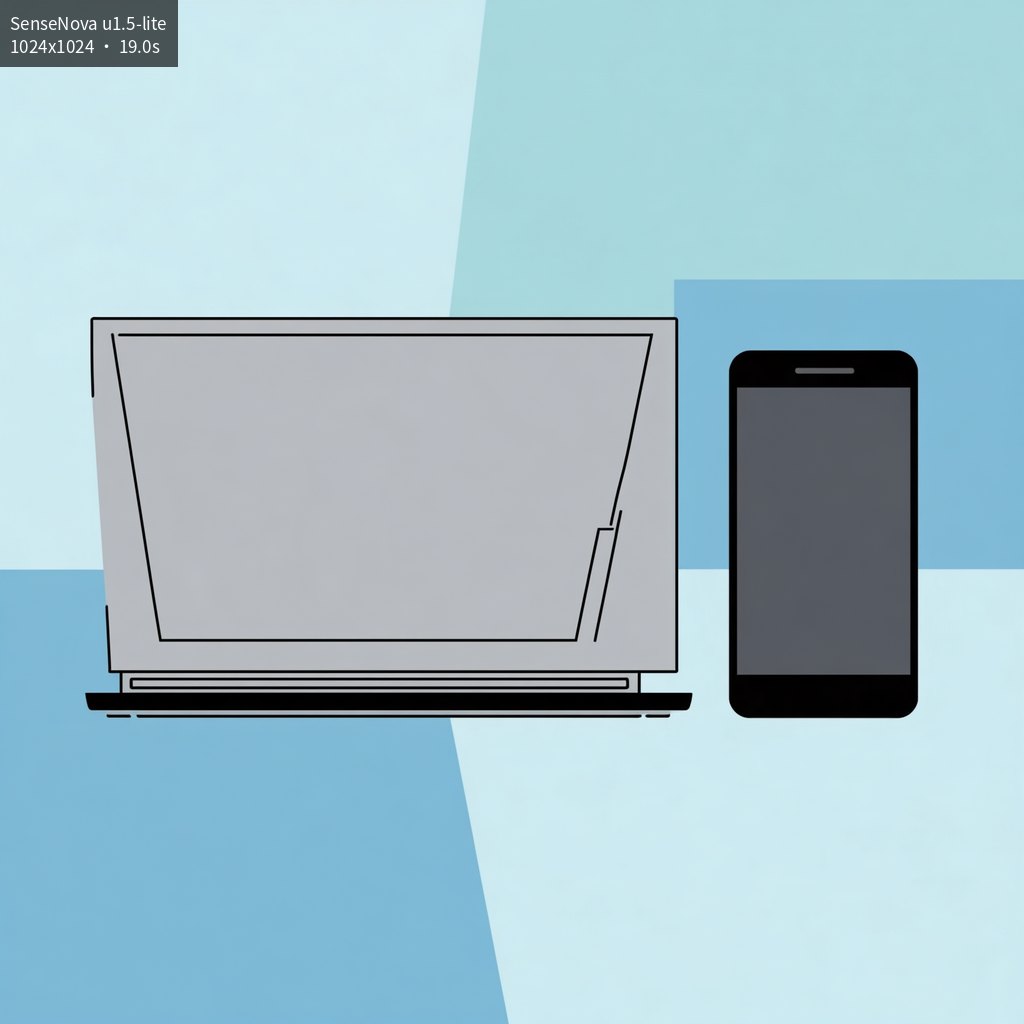
图 8:04 组 SenseNova u1.5-lite。设备被高度概括成空壳:屏幕没内容、没按键、没接口,笔记本外框还有断线和缺口。
写实和氛围类的题材,两家水平接近,SenseNova 的水墨留白和逆光氛围甚至更自然。但一碰到需要画"具体物件"的题材(扁平插画、产品图),差距立刻拉开。
3D 渲染那组两家都过得去:
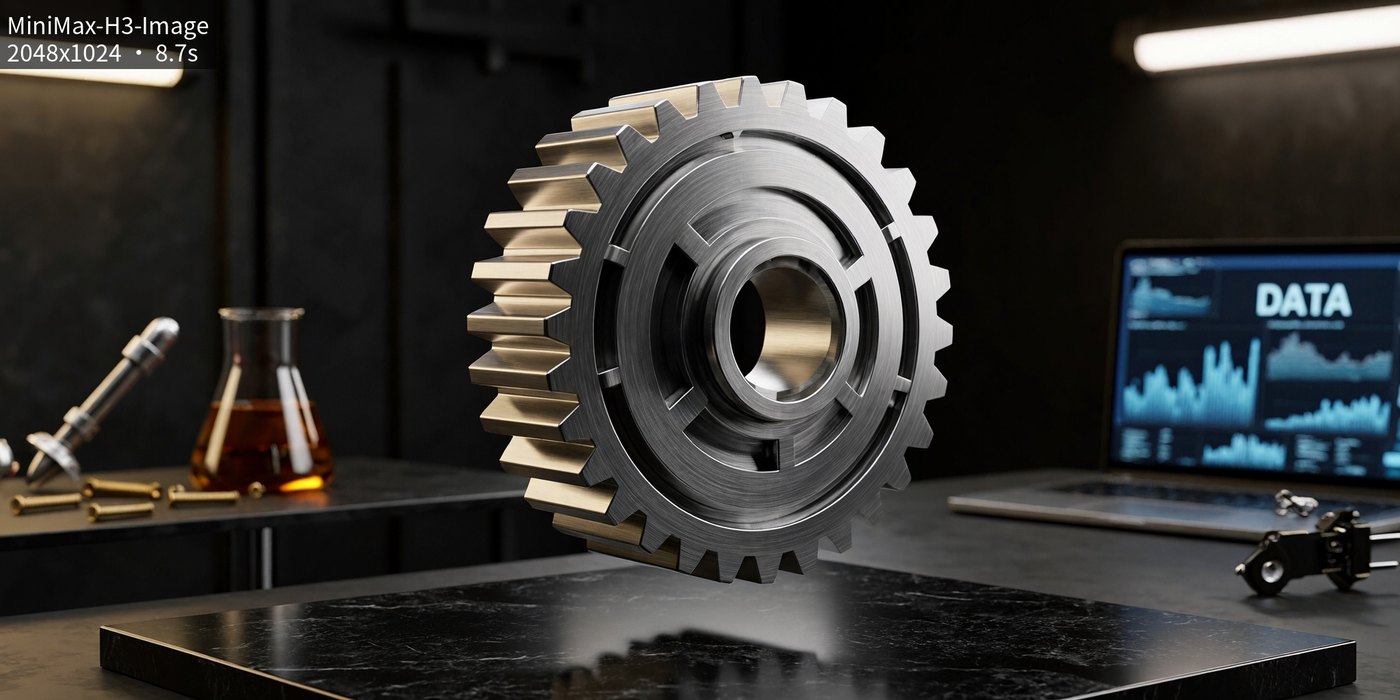
图 9:05 组 MiniMax-H3-Image,8.7 秒,全组最快。金属拉丝质感和布光是广告级。
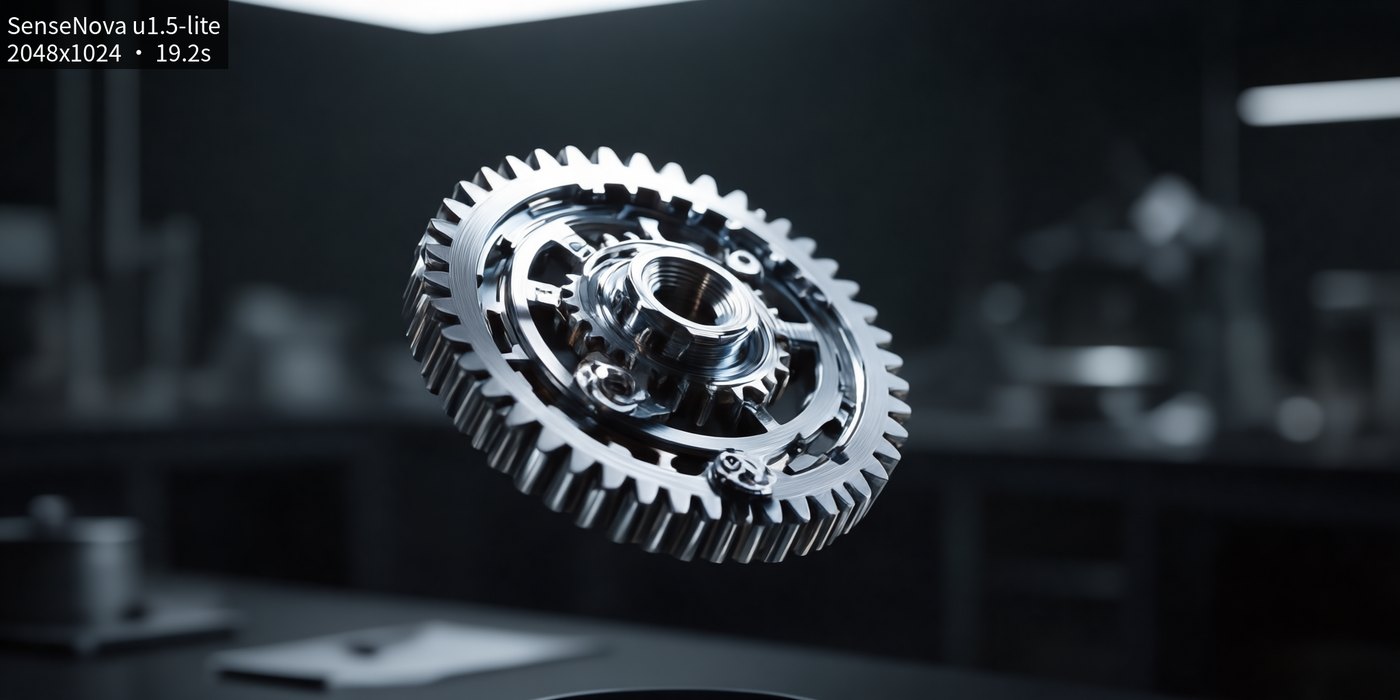
图 10:05 组 SenseNova u1.5-lite。多层同心齿圈的机械结构更复杂,但齿轮上缘高光过曝。
第五个结论:伪汉字问题,取决于构图而不是模型
赛博朋克那组是本轮信息量最大的:
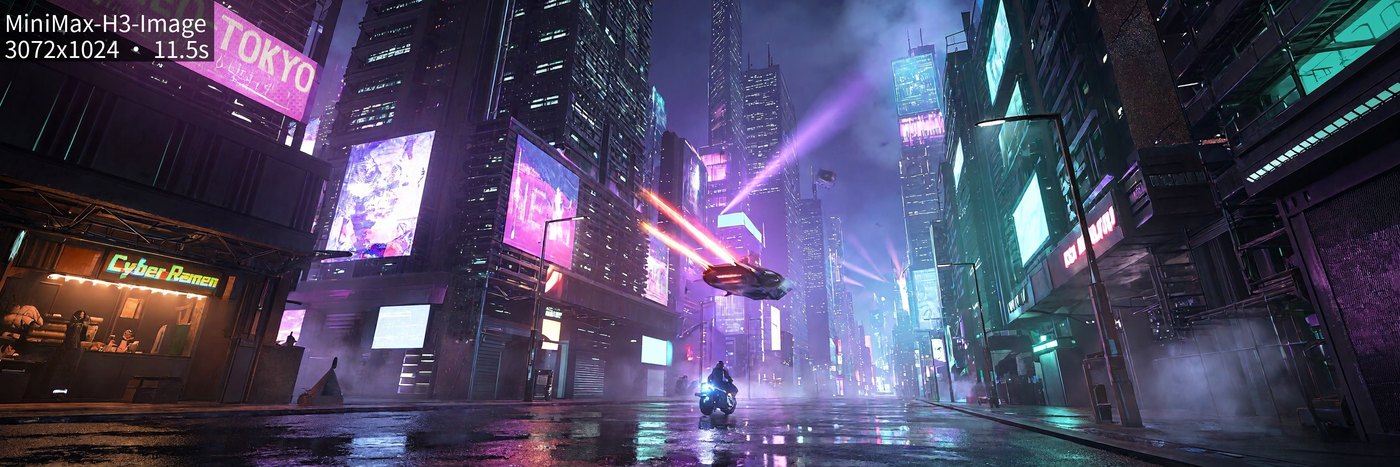
图 11:02 组 MiniMax-H3-Image。摊位招牌拼错成 "Cyber Remen",多数招牌是不可读的伪文字。
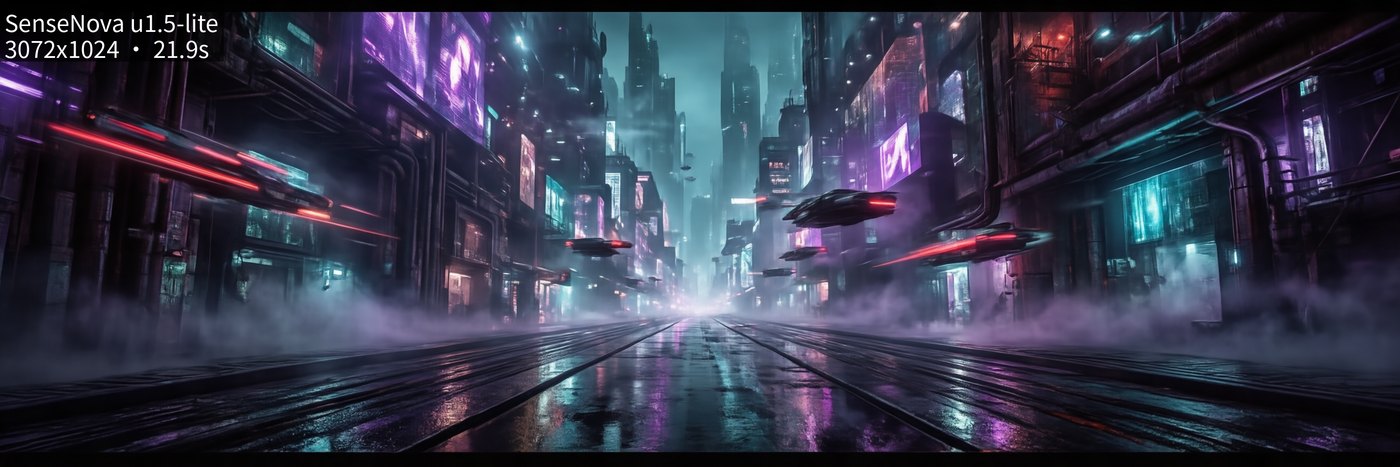
图 12:02 组 SenseNova u1.5-lite。伪文字几乎全是抽象方块符号,没有一句假英文词。
两家都在霓虹招牌和电子屏上生成了不成词的伪汉字。区别在伪文字的形态:H3 除伪汉字外还会编造英文词——"TOKYO" 可读,但摊位招牌拼错、旁边的红白招牌疑似 "ON AIR" 却字母扭曲;SenseNova 的伪文字基本是抽象符号,反而没那么刺眼。
其余五组(写实、水墨、扁平、3D、线稿)全部零伪汉字。哪怕是书本这种天然含文字的元素,只要页面留白就没有问题。
结论和之前多次实测一致:伪文字只在招牌、屏幕这类天然含文字的元素上冒出来,跟用哪个模型无关。 所以标题文案永远不要写进生图提示词——标题走后期叠加,含霓虹招牌的构图则直接避开或后期处理。
总结
| 维度 | MiniMax-H3-Image | SenseNova u1.5-lite |
| 出图速度 | 均值 9.9 秒,快约一倍 | 均值 20.4 秒 |
| 尺寸控制 | 6/6 精确命中,宽松 | 6/6 精确命中,但有 32 倍数等硬规则 |
| 提示词还原 | 主动补充细节和文字 | 只画点名的内容 |
| 细节完成度 | 产品/插画类明显更强 | 写实氛围类接近,插画类偏粗糙 |
| 伪汉字 | 含招牌场景会出现,会编造假英文词 | 同样出现,但多为抽象符号 |
| 水印 | 无 | 需显式传 watermark:false |
具体怎么选:
- 默认后端用 H3——快一倍、细节更完整,12 张实测零失败
- 所有出图尺寸对齐 32 的倍数,避开 SenseNova 的 400 报错
- 标题一律后期叠加,不写进提示词
- 要求"严格按提示词走、不许加料"时,切到 SenseNova
- 含霓虹招牌、电子屏的构图,两家都别直接用
这次是横向对比实测,12 张图全部保留在报告里,每张图的左上角都标了模型、尺寸和耗时,可以自己比对。

文章评论